Lorsqu’un robot humanoïde ouvre une porte ou déplace un objet dans une vidéo, le résultat ne dit pas comment il a appris. Un humain peut l’avoir piloté directement, une politique de contrôle peut avoir été entraînée à partir de démonstrations, ou la compétence peut avoir été travaillée en simulation avant d’être transférée sur la machine. Ces approches répondent à des problèmes différents et sont souvent combinées.
La téléopération transforme le geste humain en données
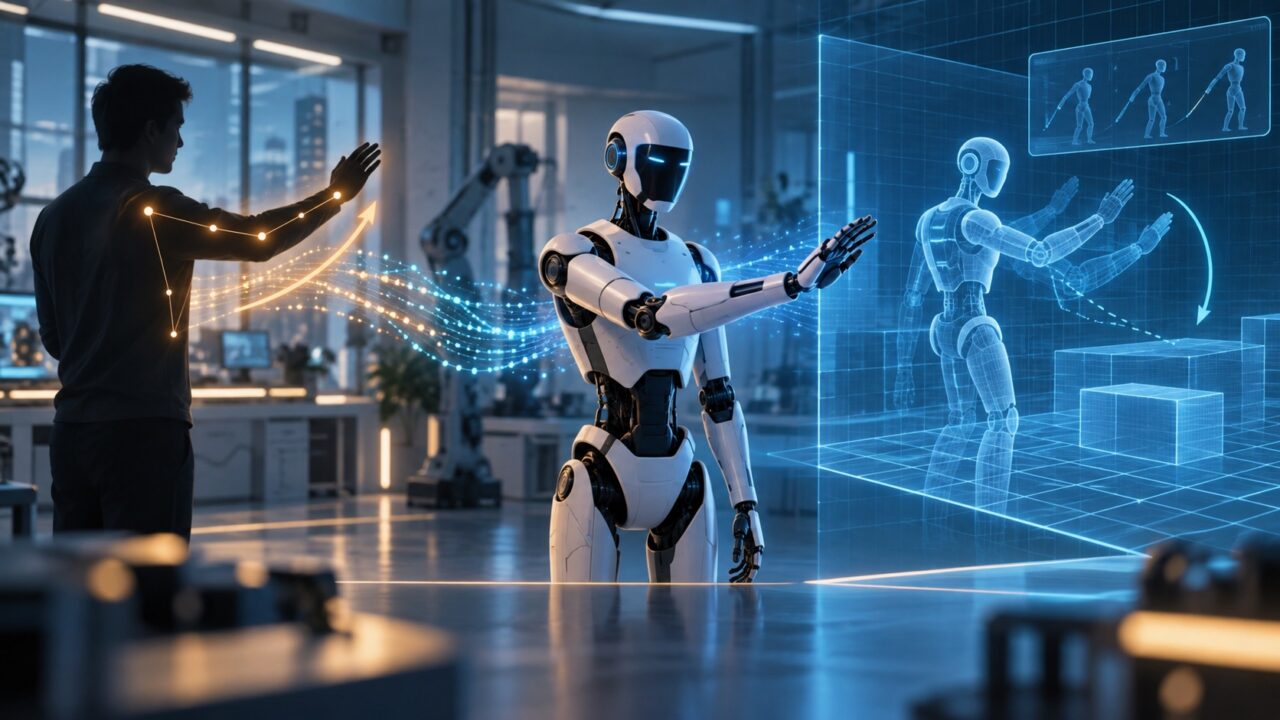
La téléopération consiste à commander un robot à distance. L’opérateur peut utiliser un casque de réalité virtuelle, des contrôleurs, une caméra ou un système de suivi du corps. Le robot ne devient pas autonome pendant cette phase : il exécute les commandes transmises, avec l’aide de contrôleurs qui maintiennent son équilibre et traduisent les gestes humains vers ses articulations.
Cette interaction sert aussi à produire des démonstrations. Chaque session peut enregistrer les observations du robot, ses mouvements et les actions demandées. Le projet TRILL recueille ainsi des démonstrations via une interface VR pour entraîner des compétences de loco-manipulation — des tâches où l’humanoïde doit se déplacer tout en agissant sur son environnement. Les auteurs ont évalué leur méthode en simulation et sur un robot réel, dans le périmètre des tâches étudiées.
Open-TeleVision explore le même besoin de données avec un retour visuel immersif. Dans l’étude publiée à CoRL, les opérateurs voient l’environnement en stéréoscopie et leurs mouvements de bras et de mains sont reproduits par le robot. Les chercheurs ont utilisé le système sur quatre tâches longues et précises, avec deux humanoïdes. C’est une validation ciblée, pas la preuve d’une dextérité générale.
L’imitation apprend une politique, pas une intelligence universelle
L’apprentissage par imitation utilise les démonstrations pour entraîner une politique de contrôle : une fonction qui choisit une action à partir de ce que le robot observe. L’objectif n’est pas de rejouer mécaniquement une trajectoire unique, mais d’apprendre une régularité suffisante pour reproduire la compétence dans les situations couvertes par l’entraînement.
La difficulté tient notamment au coût des bonnes données. Un humanoïde possède de nombreuses articulations, doit rester stable et interagit avec des objets réels. Les démonstrations peuvent varier selon l’opérateur, le point de vue ou la précision du matériel. Une politique peut donc réussir dans une configuration et échouer dès que l’objet, la lumière ou la position de départ change.
Le mot « imitation » ne signifie pas non plus que le robot comprend l’intention humaine au sens large. Il décrit ici une méthode d’apprentissage fondée sur des exemples. La portée réelle dépend du jeu de données, de la tâche, du robot et des tests.
La simulation fournit de l’échelle, mais pas une copie parfaite du réel
La simulation permet d’essayer beaucoup de mouvements sans user un robot physique ni exposer son matériel à chaque chute. Elle facilite aussi l’entraînement parallèle et la variation des conditions : masses, frottements, positions ou perturbations. Une politique peut ainsi accumuler une expérience impossible à collecter aussi vite dans un laboratoire.
Mais un simulateur reste un modèle. Les moteurs, les délais de commande, les contacts et les surfaces ne se comportent jamais exactement comme dans le monde physique. C’est le problème du transfert « sim-to-real ». Un rapport du Robotics Institute de Carnegie Mellon décrit par exemple une boucle où des déploiements sur un humanoïde réel servent à apprendre une correction de dynamique, ensuite réinjectée dans la simulation. Cette méthode vise un écart précis ; elle ne supprime pas toutes les incertitudes du terrain.
Une réussite simulée est donc une étape de développement, pas une garantie. Elle doit être suivie de tests physiques, avec des critères de sécurité, de répétabilité et de robustesse.
Les approches se complètent plus souvent qu’elles ne s’excluent
Un pipeline peut commencer par des gestes humains, entraîner une politique d’imitation, l’améliorer ou la tester en simulation, puis revenir sur le robot réel. Les données physiques révèlent alors les erreurs que le modèle virtuel ne reproduisait pas. Cette boucle explique pourquoi les frontières entre téléopération, imitation et simulation sont moins nettes que ne le suggèrent certaines annonces.
Le contexte industriel ajoute encore une autre contrainte : il faut obtenir des données variées sans multiplier les interventions coûteuses. Notre article sur Mecka AI illustre cette recherche de données humaines pour entraîner des robots, mais une stratégie d’entreprise ou une levée de fonds ne valide pas à elle seule la généralisation d’une méthode.
MotionDisco explore une voie sans démonstration téléopérée
MotionDisco, présenté en juin 2026, cherche à découvrir automatiquement des trajectoires longues et riches en contacts. Selon les auteurs, le cadre combine une recherche évolutionnaire guidée par un grand modèle de langage, un optimiseur de trajectoires et une stratégie d’élagage. Les mouvements trouvés servent ensuite à entraîner des politiques de suivi transférées sur un humanoïde réel.
Dans ce cadre précis, « sans téléopération » signifie que les trajectoires ne viennent pas d’un opérateur humain ni d’un retargeting de démonstrations humaines. Cela ne signifie pas que le système apprend sans objectif, sans simulateur, sans ingénierie ou sans validation. Notre article consacré à MotionDisco détaille les mouvements présentés par l’équipe et leur contexte expérimental.
Cette approche n’est pas directement comparable à TRILL ou Open-TeleVision sur un classement unique : les tâches, les robots et les protocoles diffèrent. Elle montre surtout qu’une partie des données de mouvement peut être produite autrement que par démonstration humaine.
Ce qu’il faut regarder derrière une démonstration de robot
Pour évaluer une annonce, commencez par identifier la tâche exacte et les conditions du test. Le robot recommence-t-il depuis plusieurs positions ? L’environnement change-t-il ? Combien d’essais réussissent ? Une intervention humaine est-elle nécessaire ? La politique a-t-elle été testée uniquement en simulation, sur un prototype ou dans un déploiement opérationnel ?
Il faut également distinguer les concepts durables des exemples datés. La téléopération restera un moyen de commande et de collecte ; l’imitation restera un apprentissage à partir de démonstrations ; la simulation restera une approximation utile. En revanche, MotionDisco, TRILL et Open-TeleVision sont des travaux associés à des matériels, des dates et des protocoles particuliers.
La question la plus utile n’est donc pas « quelle méthode gagne ? », mais « quelles données, quel environnement et quelle validation ont produit cette compétence ? ». C’est cette chaîne de preuves qui permet de distinguer une démonstration impressionnante d’une capacité réellement robuste.